PDF 转文字 TXT — 操作步骤与实测
实测日期: · ToolMiko
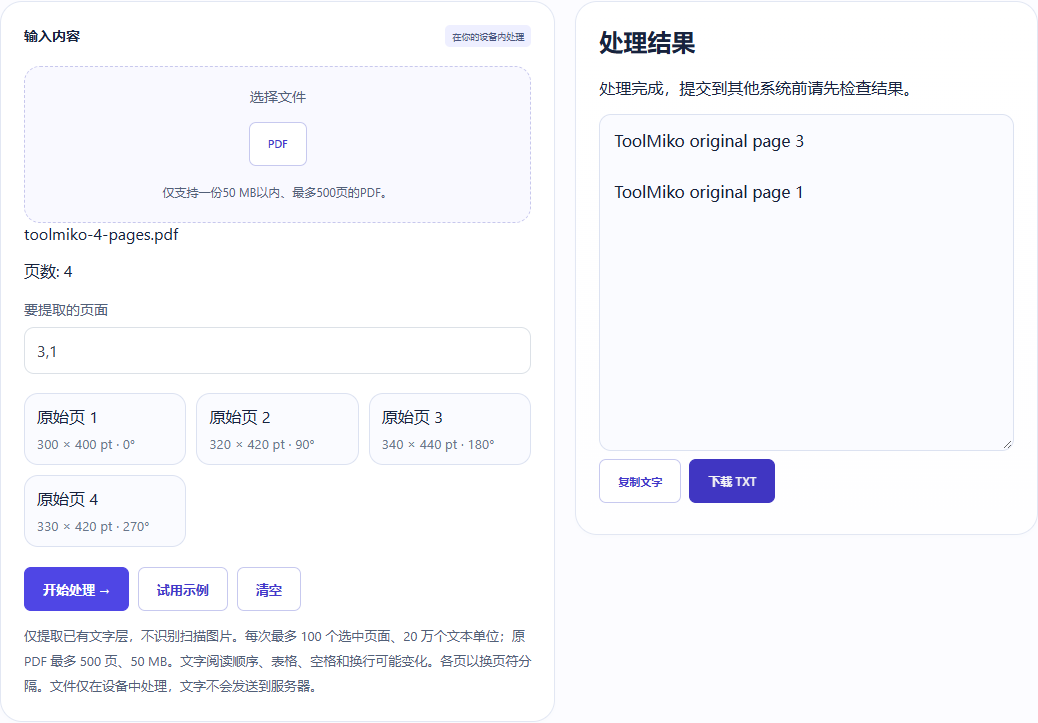
载入四页样例,提取第 3、1 页,TXT 先包含 original page 3,再包含 original page 1。
PDF 转文字 TXT →操作步骤与实测
- 选择有文字层的未加密 PDF,等待页数显示;扫描图片不能在这里直接识别。
- 输入页码或范围(如 3,1),文字按所填顺序提取。
- 开始处理,核对提取文字和阅读顺序,再复制文字或下载 UTF-8 TXT。
生成样例与下载结果
样例不含用户文件;截图和可下载结果来自本工具的实际操作。
限制与核对
仅提取已有文字层,不识别扫描图片。每次最多 100 个选中页面、20 万个文本单位;原 PDF 最多 500 页、50 MB。文字阅读顺序、表格、空格和换行可能变化。各页以换页符分隔。文件仅在设备中处理,文字不会发送到服务器。
扫描件:手动转图片后再识别
这里不提供内置 PDF OCR。若没有文字层,可按以下路径操作:
- 在 PDF 转图片中选一页并导出 PNG。 打开 PDF 转图片
- 在图片转文字 OCR 中选择刚下载的 PNG,再选择对应的印刷文字语言并开始识别。 打开图片转文字 OCR
核对识别文字,尤其是数字和换行,再复制或下载 TXT;不能保证准确率或还原原版式。