PDF থেকে টেক্সট TXT — ধাপ ও পরীক্ষিত উদাহরণ
পরীক্ষার দিন: · ToolMiko
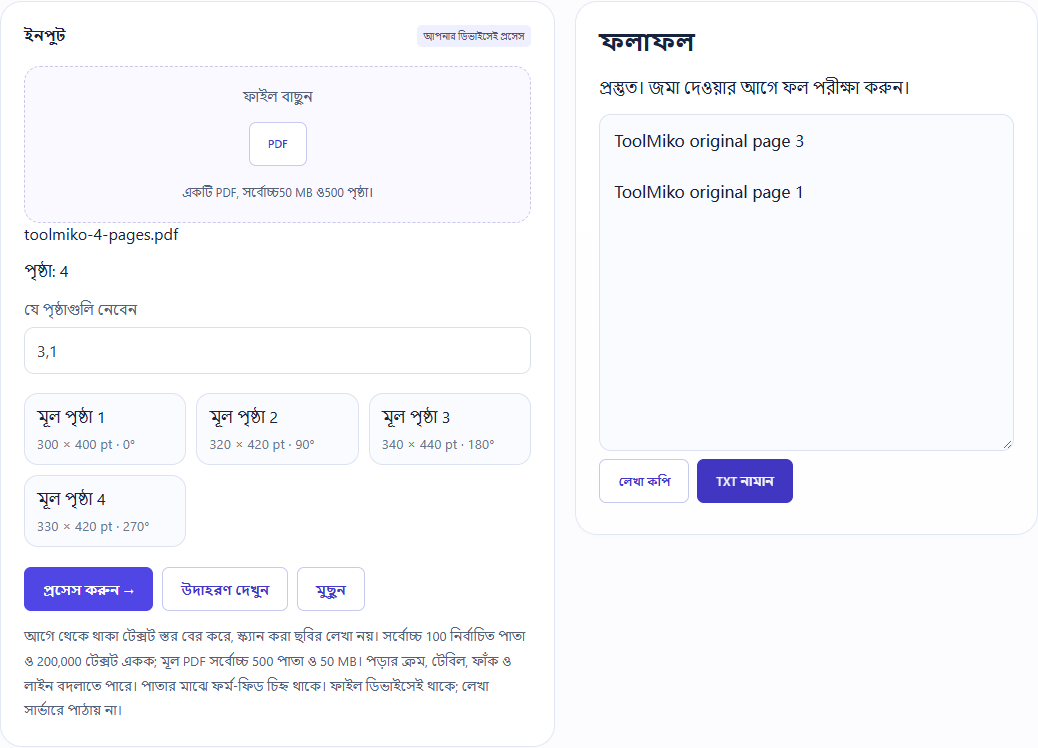
চার পাতার নমুনা লোড করে 3,1 বাছুন। TXT-তে original page 3 থাকবে original page 1-এর আগে।
PDF থেকে টেক্সট TXT →ধাপ ও পরীক্ষিত উদাহরণ
- টেক্সট স্তরসহ এনক্রিপশনহীন PDF বেছে পাতার সংখ্যা আসা পর্যন্ত অপেক্ষা করুন। এখানে স্ক্যান করা ছবির লেখা চেনা যায় না।
- পাতা বা রেঞ্জ দিন, যেমন 3,1; লেখা আপনার দেওয়া ক্রমে আসবে।
- চালিয়ে লেখা ও পড়ার ক্রম যাচাই করুন, তারপর কপি করুন বা UTF-8 TXT নামান।
তৈরি নমুনা ও নামানো ফল
নমুনায় ব্যবহারকারীর ফাইল নেই। স্ক্রিনশট ও ডাউনলোডযোগ্য ফল এই টুলের বাস্তব ব্যবহার থেকে নেওয়া।
সীমা ও যাচাই
আগে থেকে থাকা টেক্সট স্তর বের করে, স্ক্যান করা ছবির লেখা নয়। সর্বোচ্চ 100 নির্বাচিত পাতা ও 200,000 টেক্সট একক; মূল PDF সর্বোচ্চ 500 পাতা ও 50 MB। পড়ার ক্রম, টেবিল, ফাঁক ও লাইন বদলাতে পারে। পাতার মাঝে ফর্ম-ফিড চিহ্ন থাকে। ফাইল ডিভাইসেই থাকে; লেখা সার্ভারে পাঠায় না।
স্ক্যান: আগে ছবি বানিয়ে তারপর নিজে OCR চালান
এই টুলে অন্তর্নির্মিত PDF OCR নেই। টেক্সট স্তর না থাকলে এই ধাপগুলো অনুসরণ করুন:
- PDF থেকে ছবি টুলে একটি পাতা বেছে PNG হিসেবে নামান। PDF থেকে ছবি খুলুন
- ছবি থেকে লেখা OCR-এ নামানো PNG বাছুন, মুদ্রিত লেখার ভাষা নির্বাচন করে শনাক্তকরণ চালান। ছবি থেকে লেখা OCR খুলুন
কপি বা TXT নামানোর আগে লেখা, বিশেষত সংখ্যা ও লাইনবিন্যাস যাচাই করুন। নির্ভুলতা বা মূল বিন্যাস ফিরে পাওয়ার নিশ্চয়তা নেই।