PDF से टेक्स्ट TXT — कदम और जाँचा उदाहरण
जाँच की तारीख: · ToolMiko
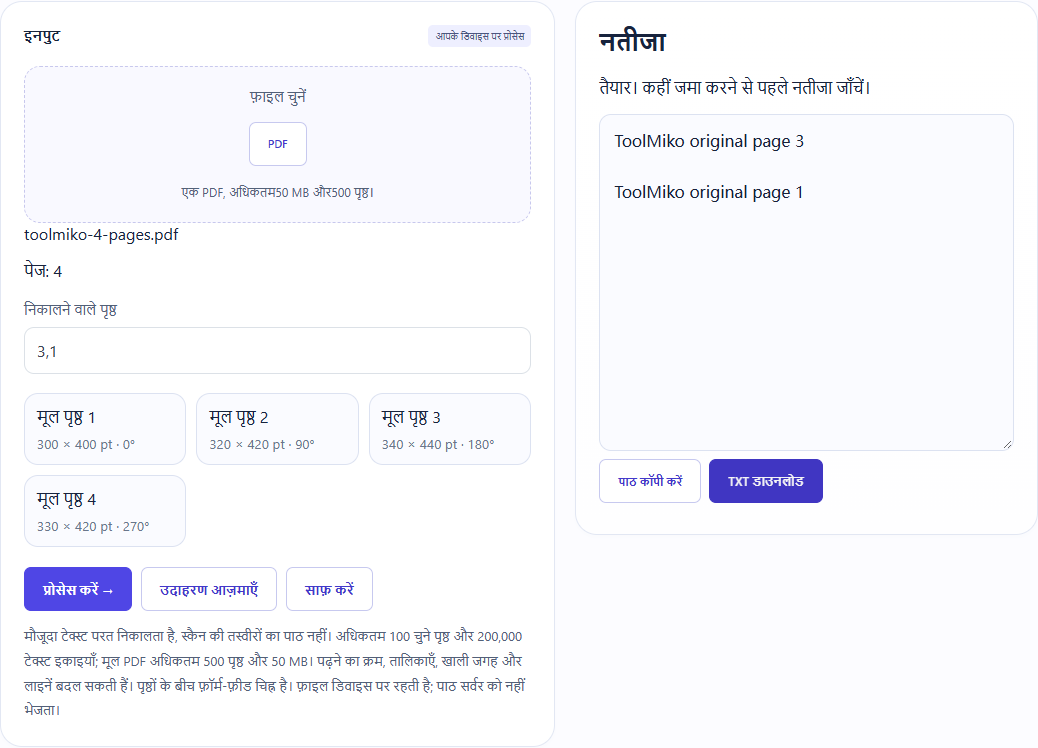
चार पृष्ठ का नमूना लोड कर 3,1 चुनें। TXT में original page 3 पहले और original page 1 बाद में होगा।
PDF से टेक्स्ट TXT →कदम और जाँचा उदाहरण
- टेक्स्ट परत वाली बिना एन्क्रिप्शन की PDF चुनें और पृष्ठ संख्या आने दें। यहाँ स्कैन की तस्वीरों का टेक्स्ट पहचाना नहीं जाता।
- पृष्ठ या रेंज दें, जैसे 3,1; टेक्स्ट आपके चुने क्रम में आएगा।
- प्रोसेस करें, टेक्स्ट और पढ़ने का क्रम जाँचें, फिर कॉपी करें या UTF-8 TXT डाउनलोड करें।
बनाया नमूना और डाउनलोड परिणाम
नमूने में उपयोगकर्ता की फ़ाइलें नहीं हैं। स्क्रीनशॉट और डाउनलोड परिणाम इस टूल के वास्तविक उपयोग से हैं।
सीमाएँ और जाँच
मौजूदा टेक्स्ट परत निकालता है, स्कैन की तस्वीरों का पाठ नहीं। अधिकतम 100 चुने पृष्ठ और 200,000 टेक्स्ट इकाइयाँ; मूल PDF अधिकतम 500 पृष्ठ और 50 MB। पढ़ने का क्रम, तालिकाएँ, खाली जगह और लाइनें बदल सकती हैं। पृष्ठों के बीच फ़ॉर्म-फ़ीड चिह्न है। फ़ाइल डिवाइस पर रहती है; पाठ सर्वर को नहीं भेजता।
स्कैन: पहले तस्वीर बनाएँ, फिर अलग से OCR चलाएँ
इस टूल में अंतर्निर्मित PDF OCR नहीं है। टेक्स्ट परत न हो तो ये कदम अपनाएँ:
- PDF से तस्वीरें टूल में एक पृष्ठ चुनकर PNG निर्यात करें। PDF से तस्वीरें खोलें
- इमेज से टेक्स्ट OCR में डाउनलोड की गई PNG चुनें, छपे हुए टेक्स्ट की भाषा चुनकर पहचान शुरू करें। इमेज से टेक्स्ट OCR खोलें
कॉपी या TXT डाउनलोड करने से पहले टेक्स्ट, खासकर संख्याएँ और लाइन ब्रेक जाँचें। सटीकता या मूल लेआउट वापस मिलने की गारंटी नहीं है।