इमेज से टेक्स्ट OCR कैसे करें? भाषा, अंकों की जाँच और TXT डाउनलोड
साफ़ इमेज और उसमें लिखी भाषा चुनकर OCR चलाएँ। फिर मूल से मिलाकर पाठ सुधारें और कॉपी याTXTडाउनलोड करें। नाम, राशि, तारीख और विराम चिह्न जाँचना ज़रूरी है; कॉन्फिडेंस स्कोर हर अक्षर सही होने का प्रमाण नहीं।
टूल खोलें: इमेज से टेक्स्ट OCR →शुरू करने से पहले क्या तैयार करें?
- साफ़ छपे पाठ वाली एक JPG, PNG या WebP लें। पहलेKBघटाने के लिए छोटे अक्षर धुँधले न करें।
- इस नमूने में अंग्रेज़ी है, इसलिए English चुनें। हिंदी, चीनी, थाई या बांग्ला के लिए वही पहचान भाषा लें। साइट की भाषा और इमेज की भाषा अलग हैं।
मूल चित्रों को एक दस्तावेज़ में भी रखना हो तो अलग से चित्रों का PDF बनाएँ। उसमें चित्र वाले पन्ने होंगे; यह TXT मिलाकर खोजने योग्य PDF नहीं बनाता। मूल चित्र और जाँचा टेक्स्ट अलग रखें। मूल चित्रों से क्रम में PDF बनाएँ →
ToolMiko में कैसे करें?
- इमेज से टेक्स्ट OCR में अंग्रेज़ी नमूना खोलें।
- इमेज भाषा English करके प्रोसेस करें। पहली बार इंजन और भाषा मॉडल लोड होते हैं।
- 1250 और 2026-11-13 को मूल इमेज से अक्षर-दर-अक्षर मिलाएँ। सिर्फ़ कुल स्कोर न देखें।
- परिणाम संपादक में गलतियाँ सुधारें। ज़रूरत पर पंक्तियाँ और तालिका के कॉलम खुद व्यवस्थित करें।
- TXTडाउनलोड कर खोलें। हमने अंत में जाँच का पाठ जोड़कर सुनिश्चित किया कि फ़ाइल वर्तमान संपादित पाठ इस्तेमाल करती है।
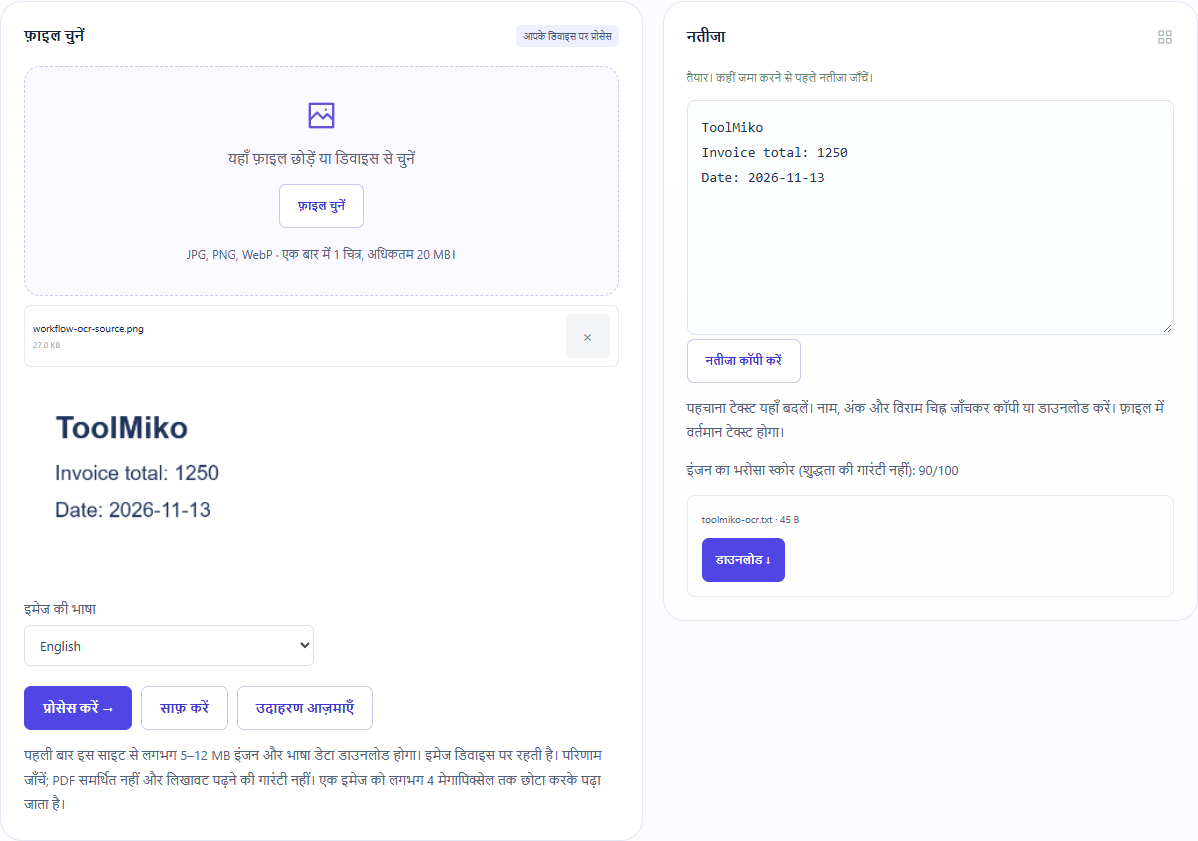
नमूने से क्या परिणाम मिला?
बनाई गई अंग्रेज़ी इमेज से नीचे की तीन पंक्तियाँ मिलीं। संपादन के बाद डाउनलोड भी मिलाया गया। यह असली बिल, लिखावट या पाँचों भाषाओं की शुद्धता का बेंचमार्क नहीं है।
| जाँच | देखा गया परिणाम |
|---|---|
| नमूने से मिला पाठ | ToolMiko Invoice total: 1250 Date: 2026-11-13 |
| संपादन के बाद डाउनलोड | जाँचा गया: डाउनलोड किया TXT वर्तमान संपादित पाठ से मेल खाता है |
इस परीक्षण का परिणाम डाउनलोड करें →
निजी जानकारी के बिना नमूने बनाकर 2026-11-13 को Windows Chrome में जाँचे गए। मूल फ़ाइल से दोबारा करें; दूसरी फ़ाइलों और उपकरणों पर परिणाम अलग हो सकता है।
नतीजा सही न हो तो क्या करें?
राशि या तारीख गलत है
मूल से0/O,1/I, दशमलव, हाइफ़न और तारीख क्रम मिलाएँ। संदर्भ देखकर वास्तविक राशि का अनुमान न लगाएँ।
पहली बार बहुत देर लोड हो रहा है
इंजन और मॉडल डाउनलोड होने चाहिए। पृष्ठ खुला रखें और नेटवर्क देखें। असफल हो तो छोटी, साफ़ इमेज से फिर करें।
PDFडालना याWordडाउनलोड करना संभव है?
अभी केवल इमेज ली जाती है और संपादन योग्य सामान्य पाठ याTXTमिलता है। PDFइनपुट, खोजने योग्यPDFयाWordलेआउट पुनर्निर्माण नहीं है।
सीमाएँ और फ़ाइल प्रबंधन
एक इमेज 20 MB तक; पहचान से पहले लगभग 40 लाख पिक्सेल में घटती है। इंजन और चुनी भाषा की फ़ाइलें इसी साइट से आती हैं, इमेज ब्राउज़र में प्रोसेस होती है, क्लाउड OCRको नहीं जाती। जटिल तालिका, धुँधली तस्वीर और लिखावट की शुद्धता तय नहीं है।