ছবি থেকে লেখা OCR: ভাষা নির্বাচন, সংখ্যা যাচাই ও TXT ডাউনলোড
পরিষ্কার ছবি ও লেখার ভাষা বেছে OCR চালান। তারপর মূল দেখে লেখা ঠিক করে কপি বাTXTডাউনলোড করুন। নাম, অঙ্ক, তারিখ ও যতিচিহ্ন যাচাই দরকার; কনফিডেন্স স্কোর সব অক্ষর ঠিক প্রমাণ করে না।
টুল খুলুন: ছবি থেকে লেখা OCR →শুরুর আগে কী লাগবে?
- পরিষ্কার ছাপা লেখা থাকা একটি JPG, PNG বা WebP নিন। আগেKBকমাতে গিয়ে ছোট লেখা ঝাপসা করবেন না।
- নমুনা ইংরেজি, তাই English বাছুন। বাংলা, চীনা, থাই বা হিন্দি ছবিতে সংশ্লিষ্ট ভাষা নিন। ওয়েবসাইটের ভাষা ও ছবির ভাষা আলাদা নির্বাচন।
মূল ছবিগুলিও একটি নথিতে রাখতে চাইলে আলাদা ছবি-PDF তৈরি করুন। এতে ছবির পৃষ্ঠা থাকে; এই TXT মিলিয়ে খোঁজার উপযোগী PDF হয় না। মূল ছবি ও যাচাই করা লেখা আলাদা রাখুন। মূল ছবিগুলি ক্রমে PDF-এ রাখুন →
ToolMiko দিয়ে কীভাবে করবেন?
- ছবি থেকে লেখা OCR খুলে ইংরেজি নমুনা দিন।
- ছবির ভাষা English করে প্রসেস শুরু করুন। প্রথমবার ইঞ্জিন ও ভাষার মডেল লোড হয়।
- 1250 ও 2026-11-13 মূল ছবির সঙ্গে মিলিয়ে দেখুন। শুধু মোট স্কোরের ওপর নির্ভর করবেন না।
- ফলের সম্পাদকেই ভুল ঠিক করুন। দরকার হলে লাইন ও টেবিলের কলাম হাতে সাজান।
- TXTডাউনলোড করে খুলুন। আমরা শেষে যাচাইয়ের লেখা যোগ করে নিশ্চিত করেছি যে ফাইল বর্তমান সম্পাদিত লেখা ব্যবহার করে।
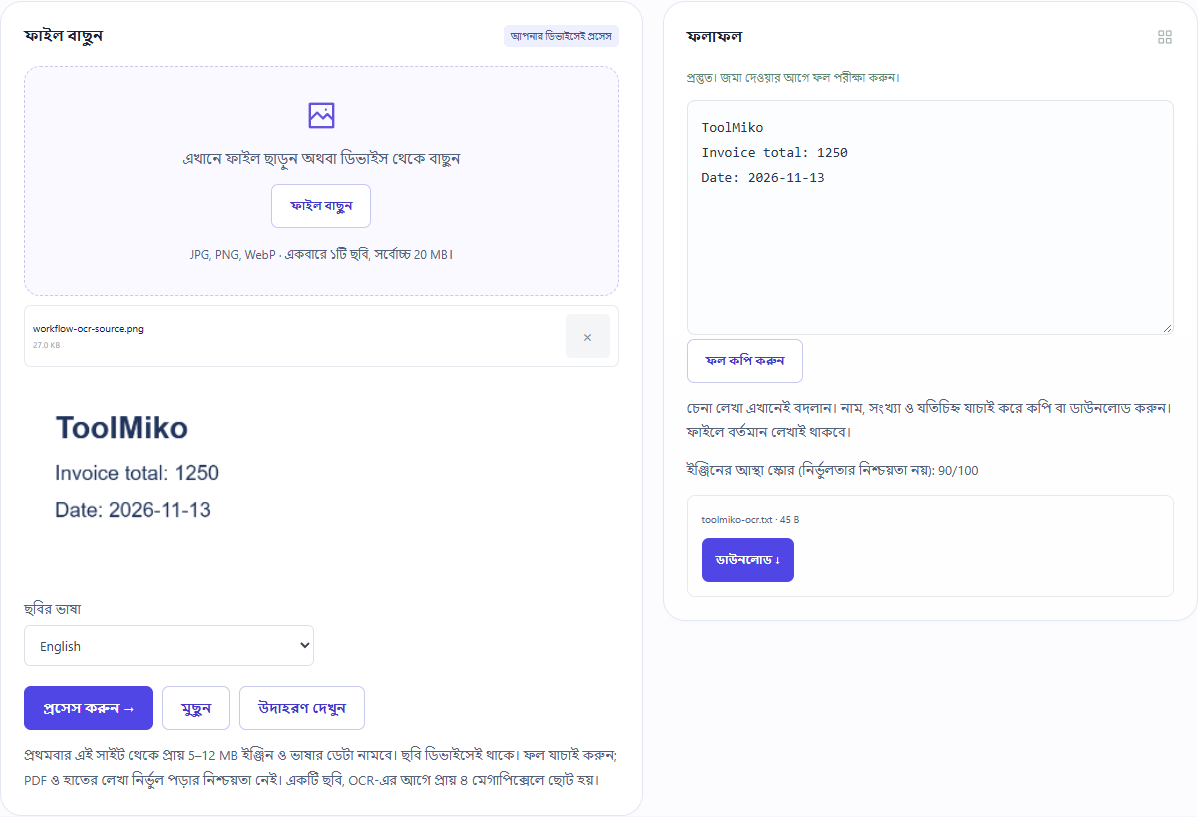
নমুনা পরীক্ষায় কী ফল পাওয়া গেছে?
তৈরি করা ইংরেজি ছবি থেকে নিচের তিন লাইন পাওয়া গেছে। সম্পাদনার পরে ডাউনলোডও মিলেছে। এটি বাস্তব বিল, হাতের লেখা বা পাঁচ ভাষার নির্ভুলতার বেঞ্চমার্ক নয়।
| যাচাই | পরীক্ষার ফল |
|---|---|
| নমুনা থেকে পাওয়া লেখা | ToolMiko Invoice total: 1250 Date: 2026-11-13 |
| সংশোধনের পর ডাউনলোড | যাচাই হয়েছে: ডাউনলোড করা TXT বর্তমান সংশোধিত লেখার সঙ্গে মেলে |
ব্যক্তিগত তথ্য ছাড়া নমুনা তৈরি করে 2026-11-13 তারিখে Windows Chrome-এ পরীক্ষা হয়েছে। মূল ফাইল দিয়ে আবার করা যায়; অন্য ফাইল ও ডিভাইসে ফল বদলাতে পারে।
ফল ঠিক না হলে কী করবেন?
অঙ্ক বা তারিখ ভুল হলে
মূলের সঙ্গে0/O,1/I, দশমিক, হাইফেন ও তারিখের ক্রম মিলিয়ে নিন। আশপাশের লেখা দেখে আসল টাকা অনুমান করবেন না।
প্রথমবার লোড হচ্ছে অনেকক্ষণ
ইঞ্জিন ও মডেল নামাতে হয়। পৃষ্ঠা খোলা রাখুন ও নেট দেখুন। ব্যর্থ হলে ছোট ও পরিষ্কার ছবি দিয়ে আবার করুন।
PDFদেওয়া বাWordনামানো যাবে?
বর্তমানে শুধু ছবি নেওয়া হয় এবং সম্পাদনযোগ্য সাধারণ লেখা বাTXTদেয়। PDFইনপুট, অনুসন্ধানযোগ্যPDFবাWordলেআউট ফেরানো হয় না।
সীমা ও ফাইল পরিচালনা
প্রতি বার একটি ছবি, সর্বোচ্চ 20 MB; OCR-এর আগে প্রায়40 লাখ পিক্সেলে ছোট হয়। ইঞ্জিন ও ভাষার ডেটা এই সাইট থেকে আসে, ছবি ব্রাউজারে প্রসেস হয়; ক্লাউড OCR-এ পাঠানো হয় না। জটিল টেবিল, ঝাপসা ছবি ও হাতের লেখার শুদ্ধতার নিশ্চয়তা নেই।