字数统计为什么和看到的字不一样?字符、单词、行与表情实测
本次两行样例得到27个字符、3个单词和2行。家庭表情👨👩👧👦看起来是一个符号,却由7个Unicode码点组成;本站字符数按码点统计,包含空格和换行。
打开工具: 字数统计 →开始前准备什么?
- 把样例文件的完整内容复制进输入框,保留中间换行。
- 先确认接收方要求的是字符、单词、字节还是AI token。
- 组合表情与带组合符号的文字,可能不按一个可见符号计数。
如何在 ToolMiko 中操作?
- 打开字数统计,粘贴两行样例。
- 运行,依次查看字符27、单词3、行数2。
- 与原文比较:ToolMiko、hello和2026是本次识别的三个词。
- 若关心AI模型输入长度,改用token计数工具,并选择对应编码。
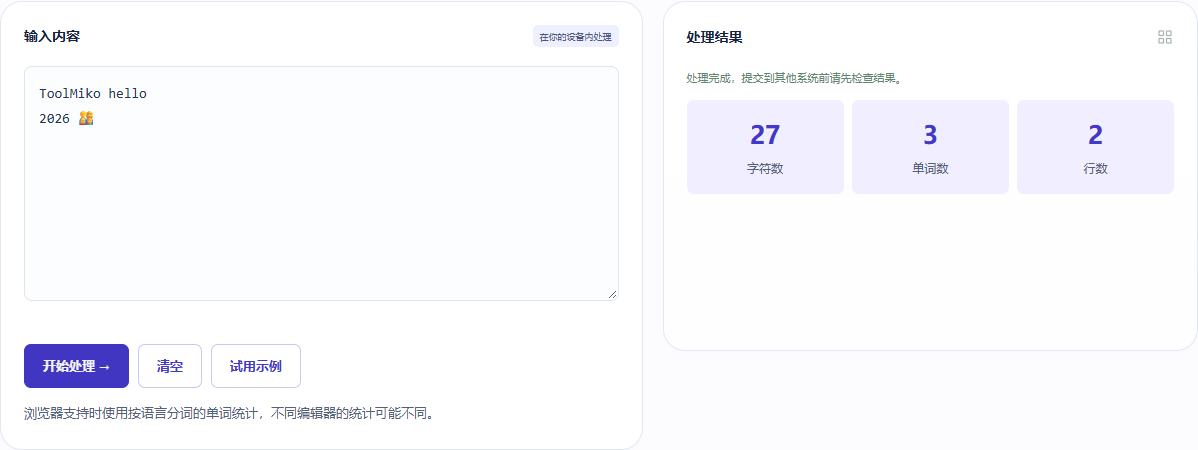
实际样例得到了什么结果?
在当前Windows Chrome的五语言界面均核对到27、3、2。源码与样例确认家庭表情包含7个码点。仅输入空白时会报错并移除旧统计;TXT为编辑记录。
| 检查项 | 本次结果 |
|---|---|
| 字符数 | 27 |
| 单词数 | 3 |
| 行数 | 2 |
样例为本站生成的非个人文件,2026-11-13 在 Windows Chrome 中运行。可用原始文件重做;不同文件与设备的结果可能不同。
结果不符合预期时怎么办?
字符数为什么比肉眼看到的多?
字符栏不是可见字形计数。空格、换行、连接符和组合标记都可能占码点。
与其他网站的单词数不一致
本站用浏览器按当前语言分词;旧浏览器可能按空白分隔。不同分词规则、文字和浏览器版本的结果可能不同。
功能边界与文件处理
输入上限为100000个UTF-16代码单元,使用浏览器本地处理。部分表情占多个单元,不是字符栏显示的码点上限。这不是UTF-8字节、字形或AI token统计;末尾换行会增加一行。样例展示计数规则,不证明五语言所有文本都与其他软件一致。